
Aplicație BrioLogic
Brio Nyx
Datele sensibile rămân la tine. Documentul pleacă curat și se întoarce întreg.
Brio Nyx este o aplicație web care găsește datele personale și confidențiale din documente, le înlocuiește cu tokeni de forma [[PER_3f2a9c1e]] și poate reface oricând originalul. Documentul anonimizat iese în același format și cu aceeași formatare: Word în Word, Excel în Excel, PDF în PDF. Îl poți trimite în siguranță unui serviciu AI, unui consultant sau unui partener, iar răspunsul primit înapoi, cu tokenii în el, se restaurează automat.
Numele vine de la Nyx, zeița primordială a nopții din mitologia greacă, asociată cu ceea ce rămâne ascuns. Tot ce este sensibil stă acoperit cât timp documentul e în afara firmei, iar totul rulează în același perimetru: aplicația, baza de date și modelele AI, prin Ollama, fără niciun apel către servicii cloud.
Pe scurt
- Folosești AI-ul fără risc. Către ChatGPT, Claude sau orice alt serviciu trimiți doar documente cu tokeni, iar răspunsul se restaurează automat.
- Minute, nu ore. Detecția automată înlocuiește căutarea manuală prin contract; omul doar verifică.
- Nimic nu scapă. Antete, subsoluri, comentarii, modificări urmărite, metadate și atașamente sunt tratate, iar documentul final este verificat încă o dată după valorile originale.
- Reversibil și consecvent. Aceeași persoană are același token în toate documentele unui proiect; originalul se reface oricând.
- Datele rămân la tine. Aplicația, baza de date și modelele AI rulează în perimetrul tău, criptat, cu jurnal de audit complet.
- Adaptabil. Tipuri de date, reguli, termeni și instrucțiuni pentru AI configurabile pe organizație și pe proiect.
Pentru cine este
Pentru organizațiile care vor să folosească AI generativ, consultanți externi sau parteneri pe documente reale, fără să expună date personale sau secrete profesionale:
- Firme de avocatură și departamente juridice. Contracte, cereri de chemare în judecată și hotărâri trimise unui AI pentru rezumat sau analiză; răspunsul revine cu numele părților restaurate.
- Bănci, IFN-uri și asigurători. Dosare de credit sau de daună date unui consultant extern sau unui furnizor de analiză, fără CNP-uri și IBAN-uri.
- Spitale și clinici. Fișe și scrisori medicale folosite în cercetare sau în instruirea personalului, fără identitatea pacienților.
- Departamente HR. CV-uri și dosare de personal analizate fără date de identificare, pentru recrutare fără prejudecăți.
- Instituții publice. Documente publicate sau puse la dispoziție la cerere, conform Legii 544/2001, cu datele persoanelor fizice ascunse.
- Echipe IT și de dezvoltare. Date reale de test (exporturi CSV, JSON, e-mailuri) pseudonimizate înainte să ajungă la echipe externe.
- Audit și consultanță. Seturi mari de documente schimbate cu auditorii, fără a expune datele clienților finali.
Problema pe care o rezolvă
Organizațiile vor să folosească AI generativ și consultanți externi pe documente reale, dar acestea conțin date personale pe care GDPR și secretul profesional nu le lasă să iasă din firmă.
- Anonimizarea manuală este lentă și nesigură. Un contract de 20 de pagini cere zeci de minute de căutare și înlocuire, iar un nume uitat într-un antet, într-un comentariu sau în metadatele fișierului este suficient pentru o scurgere de date.
- Înlocuirea cu „XXX” este ireversibilă. După ce documentul a fost prelucrat de un AI sau de un consultant, rezultatul nu mai poate fi legat de persoanele reale.
- Instrumentele cloud mută problema, nu o rezolvă. Ca să anonimizeze, trimit chiar datele sensibile către un server terț.
- Datele ascunse scapă cel mai ușor: autorul din proprietățile documentului, modificările urmărite, comentariile, notele de subsol, textul din PDF acoperit doar vizual cu un dreptunghi negru.
Brio Nyx le rezolvă pe toate patru: detecție automată verificată de un om, tokeni reversibili, procesare integral locală și tratarea tuturor zonelor ascunse ale fișierului.
Cum funcționează
În afara perimetrului pleacă doar documentul cu tokeni. Cheia de restaurare rămâne în tabela de translație, criptată, la tine.
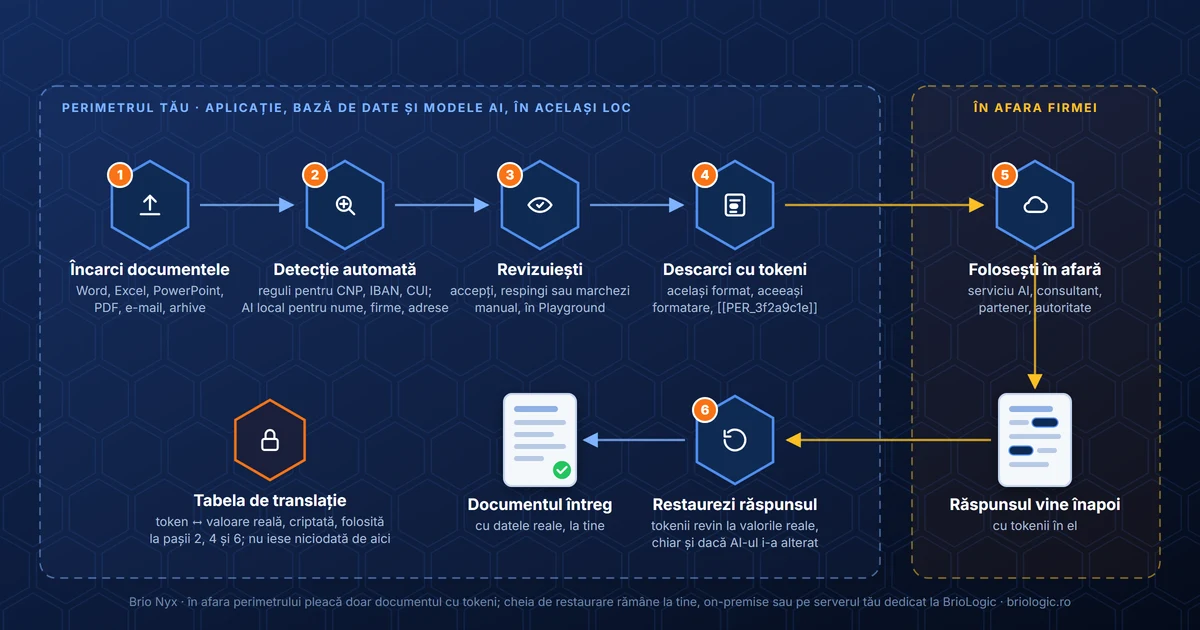
- Încarci documentele în Content Manager sau direct într-un proiect: fișiere individuale, drag & drop sau arhive ZIP și 7z.
- Aplicația detectează datele sensibile: regulile găsesc identificatorii (CNP, IBAN, CUI), iar modelul AI local găsește nume, firme și adrese.
- Revizuiești în Playground: accepți, respingi sau marchezi manual, direct pe text. Pentru loturi mari se poate aplica automat.
- Descarci documentul anonimizat, în același format și cu aceeași formatare. Fiecare entitate are un token unic în proiect.
- Îl folosești în afara firmei: îl trimiți la un serviciu AI, unui consultant sau unui partener.
- Restaurezi răspunsul: încarci fișierul primit sau lipești textul, iar tokenii revin la valorile reale.
Același paragraf, înainte și după
Datele din exemplu sunt fictive. „Alfa Bank SA” și „SC Beta Consult SRL” primesc tokeni diferiți, dar „Beta Consult”, „BETA CONSULT S.R.L.” și „Beta Consult SRL” din alte documente ale proiectului primesc același token.
Ce date recunoaște
Detecția este hibridă. Identificatorii cu format fix sunt găsiți cu reguli și verificați matematic acolo unde există cifră de control: un număr care doar seamănă cu un CNP nu este înlocuit. Datele fără format fix (nume, firme, adrese, date de naștere) sunt găsite de un model de limbaj care înțelege contextul: „data nașterii” se anonimizează, data facturii nu.
| Tip de date | Token | Cum se detectează |
|---|---|---|
| Persoană | PER | AI, din context |
| Organizație | ORG | AI, din context |
| Adresă | ADR | AI, din context |
| Dată de naștere | DOB | AI, doar când contextul o arată |
| CNP | CNP | regulă, cifră de control, dată și cod de județ |
| CUI / CIF | CUI | regulă și cifră de control |
| IBAN | IBN | regulă și algoritmul mod 97 |
| Card bancar | CRD | regulă și algoritmul Luhn (opțional) |
| Nr. Registrul Comerțului | NRC | regulă, format vechi și nou |
EML | regulă | |
| Telefon | TEL | regulă, mobil și fix românesc |
| Serie și număr CI | CI | regulă |
| Număr de înmatriculare | AUT | regulă, toate județele |
- Protecție anti-halucinație: orice entitate propusă de AI care nu apare exact în text este eliminată automat.
- Titlurile sunt ignorate („dl.”, „dr.”, „av.”), ca aceeași persoană să primească același token oriunde apare.
- Variantele unei firme sunt unite: „SC Alfa SRL”, „ALFA S.R.L.” și „Alfa” primesc același token.
- Tipuri noi, reguli proprii. Administratorii adaugă tipuri de date cu propriile reguli și pot edita instrucțiunile date modelului AI, cu istoric de versiuni.
Formate suportate, cu formatarea păstrată
- Word, Excel, PowerPoint (docx, xlsx, pptx): text, tabele, antete și subsoluri, note, comentarii, modificări urmărite, coduri de câmp, metadate (autor, companie), linkuri.
- PDF: redactare reală, textul vechi este scos din fișier, nu doar acoperit. Stil la alegere: în linie sau casetă neagră clasică, cu tokenul în alb.
- Formate vechi și deschise: doc, xls, ppt, rtf, odt, ods, odp.
- E-mail (EML): expeditor, destinatari, subiect, corp text și HTML, plus atașamentele, procesate recursiv.
- Text: txt, csv, md, json, xml, html, cu păstrarea codificării originale.
- Arhive ZIP și 7z, inclusiv cu parolă: importate dintr-o mișcare, fiecare arhivă devine un proiect.
Revizuire, proiecte și restaurare
Revizuire umană în Playground
- Fiecare entitate detectată apare colorată pe text, cu locul exact din document: antet, celula B2, pagina 1, atașament.
- Accepți sau respingi, schimbi tipul, selectezi orice fragment și îl marchezi manual, pentru toate aparițiile.
- Variantele aceleiași persoane („Popescu Ion” și „Ion Popescu”) se unesc sub un singur token.
- Previzualizare cu aspectul original și comparare side-by-side între versiuni, cu diferențele evidențiate la nivel de cuvânt.
- O decizie se poate ridica la nivel de proiect: „Nu anonimiza niciodată” sau „Anonimizează întotdeauna”.
Proiecte și tabela de translație
- Aceeași persoană primește același token în toate documentele proiectului, deci relațiile dintre documente se păstrează.
- Termeni proprii: lista „anonimizează întotdeauna” (nume de proiecte, coduri interne) și lista „nu anonimiza niciodată” (numele propriei firme, instituții publice).
- Valorile reale sunt afișate mascat („I•• P••••••”); dezvăluirea cere drept de editare și intră în jurnalul de audit.
- Membri cu roluri pe proiect (editor, vizualizator); un vizualizator poate descărca doar versiunile anonimizate.
Restaurare (de-anonimizare)
- Funcționează pe orice document cu tokeni ai proiectului, inclusiv pe unul nou, primit înapoi de la un AI extern sau de la un consultant.
- Recunoaște și tokenii alterați de AI (paranteze pierdute, majuscule schimbate) și raportează tokenii necunoscuți.
- Merge pe fișier sau pe text lipit, cu rezultatul gata de copiat.
Productivitate și administrare
- Anonimizare în bloc, pe o selecție sau pe un proiect întreg, cu aplicare automată sau cu revizuire document cu document („Următorul de revizuit”).
- Procesare în fundal, cu progres live și notificări la finalizare; export ZIP al unui proiect sau al unei selecții, opțional criptat AES-256.
- Recunoaște documentele deja anonimizate la reîncărcare și nu le anonimizează a doua oară.
- Dashboard cu proiecte, documente, joburi în lucru și entități pe tipuri; monitorizarea serverelor AI: cereri, erori, latență, tokeni consumați, pe model, server și utilizator.
- Mai multe servere Ollama în rețea, cu distribuirea încărcării și trecere automată pe alt server când unul cade.
- Utilizatori cu roluri (administrator, utilizator, auditor), jurnal de audit complet, interfață în română și engleză, temă luminoasă și întunecată.
Securitate, confidențialitate și GDPR
Nicio dată nu iese din perimetrul tău: aplicația, baza de date și modelele AI rulează pe același server sau în aceeași rețea, iar tot ce este sensibil este stocat criptat.
| Procesare | integral în perimetrul tău; modelele AI rulează local prin Ollama, fără apeluri către servicii cloud |
|---|---|
| Fișiere | criptate AES-256-GCM pe disc; la ștergere sunt suprascrise înainte de eliminare |
| Tabela de translație | valorile originale criptate; căutarea se face după amprentă HMAC, nu după text clar |
| Chei de criptare | rotire a cheii fără pierdere de date; aplicația refuză să pornească cu o cheie greșită |
| Autentificare | parole argon2, politică de complexitate, sesiuni scurte, cu reînnoire sigură |
| Atacuri de autentificare | blocare pe cont și adresă IP, întârziere crescătoare, alertă la atac distribuit |
| Acces | roluri globale și pe proiect; un proiect la care nu ai acces nici nu apare |
| Audit | fiecare descărcare, dezvăluire de valoare reală și modificare administrativă este jurnalizată; arhive de audit criptate |
| Rețea | acces doar prin HTTPS, antete de securitate (CSP, HSTS), cont SQL dedicat cu drepturi minime |
| Continuitate | backup și restaurare verificate cu sume de control; retenție configurabilă a documentelor și jurnalelor |
| Verificare finală | după anonimizare, documentul rezultat este scanat din nou după valorile originale; orice rest este raportat |
Tehnic, tokenizarea reversibilă este pseudonimizare în sensul art. 4(5) GDPR, nu anonimizare ireversibilă, pentru că la tine există cheia de restaurare. Este exact avantajul produsului. Brio Nyx sprijină principiile minimizării datelor, pseudonimizării și securității prelucrării; conformitatea ține de felul în care îl folosești, iar noi te ajutăm cu documentația de prelucrare.
Unde rulează
Pe serverele tale (on-premise)
Brio Nyx se livrează ca set de containere Docker Compose și se instalează în infrastructura ta, fără dependențe externe și fără acces la internet în funcționare. Din exterior se vede doar portul HTTPS al proxy-ului. Pentru detecția AI ai nevoie de unul sau mai multe servere cu GPU pe care rulează Ollama; aplicația distribuie cererile între ele și le ocolește automat pe cele căzute.
Găzduit de BrioLogic
Dacă nu ai un server cu GPU sau nu vrei să administrezi infrastructura, îți punem la dispoziție un server dedicat, administrat de noi, în România: aplicația, baza de date și modelele AI rulează împreună pe el, iar noi ne ocupăm de instalare, actualizări, backup și monitorizare. Documentele tale nu ajung la niciun furnizor de AI din cloud nici în această variantă.
În ambele cazuri, setarea inițială, instruirea echipei și suportul fac parte din serviciul BrioLogic.
Tehnologii
| Interfață | React, TypeScript, Mantine, Vite; bilingvă, temă luminoasă și întunecată |
|---|---|
| API | Python, FastAPI, SQLAlchemy: autentificare, drepturi, proiecte, documente, audit |
| Worker | Python, PyMuPDF, lxml, LibreOffice headless: detecție, anonimizare, restaurare și conversii, în fundal |
| Bază de date | Microsoft SQL Server 2022: metadate, coada de joburi, tabela de translație criptată |
| AI | Ollama cu modele open-weight (implicit Qwen3 30B), pentru nume, firme și adrese; modelul și instrucțiunile se aleg din interfață, pe organizație și pe proiect |
| Proxy | Caddy: HTTPS cu certificat intern sau propriu, antete de securitate |
| Operare | scripturi de backup și restaurare cu verificarea integrității și a cheii de criptare; peste 190 de teste automate și o suită de evaluare a preciziei detecției |
Brio Nyx și Brio DocForge
Brio DocForge are și el o funcție de anonimizare, dar cele două produse rezolvă probleme diferite și se completează.
| Brio DocForge | Brio Nyx | |
|---|---|---|
| Ce face | redactare manuală: tragi dreptunghiuri peste ce trebuie să dispară | detecție automată a datelor personale, cu reguli și AI local |
| Rezultat | definitiv: conținutul este eliminat din fișier | reversibil: tokeni care se pot restaura oricând |
| Formate | Word, Excel, PowerPoint, PDF, e-mail, text, arhive | |
| Potrivit pentru | documente care trebuie publicate sau predate fără datele acoperite, pentru totdeauna | documente care pleacă la un AI, un consultant sau un partener și al căror răspuns trebuie legat înapoi de persoanele reale |
| Documente scanate | da, cu OCR în română | nu în versiunea actuală |
Ce nu face
- Nu procesează documente scanate. Brio Nyx lucrează pe text; OCR-ul nu este inclus. Pentru pagini scanate folosește Brio DocForge sau Brio Argus.
- Nu face anonimizare ireversibilă. Tokenii se pot restaura de oricine are drepturi pe proiect. Pentru redactare definitivă în PDF folosește DocForge.
- Nu folosește modele AI din cloud. Este o alegere de proiectare: detecția rulează doar pe Ollama, local, ceea ce înseamnă că ai nevoie de un server cu GPU, al tău sau administrat de BrioLogic.
- Nu înlocuiește verificarea umană. Detecția automată, protecția anti-halucinație și verificarea finală reduc mult riscul, dar revizuirea în Playground rămâne pasul care îți dă certitudine, mai ales la primele documente dintr-un proiect.
- Nu se autentifică încă prin LDAP sau Active Directory. Conturile sunt administrate în aplicație; integrarea cu directorul firmei este pe plan.
Întrebări frecvente
Datele mele ajung pe internet?
Nu. Aplicația, baza de date și modelele AI rulează în același perimetru: pe serverele tale sau pe un server dedicat administrat de BrioLogic. Nu există apeluri către servicii cloud. În afară pleacă doar documentul cu tokeni, și doar când îl trimiți tu.
Pot recupera documentul original?
Da. Corespondența dintre tokeni și valorile reale se păstrează criptat, pe proiect, iar orice document cu tokenii proiectului se poate restaura, chiar și unul rescris de un AI sau de un consultant.
Este anonimizare sau pseudonimizare în sensul GDPR?
Tehnic, tokenizarea reversibilă este pseudonimizare în sensul art. 4(5) GDPR, pentru că la tine există cheia de restaurare. Este exact avantajul produsului: documentul care pleacă nu conține date personale, iar tu rămâi singurul care le poate reface. Brio Nyx sprijină principiile minimizării datelor, pseudonimizării și securității prelucrării; conformitatea depinde de felul în care îl folosești.
Cât de precisă este detecția?
Pe corpusul nostru intern de test, de 12 documente, modelul implicit a găsit toate datele personale (recall 100%, F1 96,4%). Corpusul este mic, așa că tratăm cifrele ca orientative. De aceea fiecare document poate fi revizuit de un om în Playground înainte de aplicare, iar documentul rezultat este scanat din nou după valorile originale.
Ce formate acceptă?
Word, Excel și PowerPoint, PDF, formatele vechi Office (doc, xls, ppt), RTF, OpenDocument (odt, ods, odp), e-mail EML cu atașamente, fișiere text (txt, csv, md, json, xml, html) și arhive ZIP sau 7z, inclusiv cu parolă.
Funcționează pe documente scanate?
Nu în versiunea actuală. Brio Nyx lucrează pe text, iar documentele scanate cer OCR, care nu este inclus. Dacă ai nevoie de OCR, Brio DocForge și Brio Argus îl oferă.
Pot adăuga propriile tipuri de date?
Da. Administratorii definesc tipuri noi, cu reguli proprii, și pot edita instrucțiunile date modelului AI, cu istoric de versiuni. Pe fiecare proiect se pot adăuga termeni care se anonimizează întotdeauna sau niciodată.
Ce hardware este necesar?
Un server Linux cu Docker pentru aplicație și baza de date și, pentru detecția AI, un server cu GPU pe care rulează Ollama. Dimensionarea depinde de volumul de documente. Dacă nu ai un server cu GPU, îți oferim unul dedicat, administrat de BrioLogic.
Interfața este în română?
Da, în română și în engleză, cu comutare dintr-un click, în temă luminoasă sau întunecată.
Vezi Brio Nyx pe documentele tale
O demonstrație durează 30 de minute, pe documente din activitatea ta, cu date fictive sau reale, în perimetrul tău.