
Cum gândește un LLM: modul thinking al Qwen3, măsurat în Ollama
Ce înseamnă „raționament” la un model de limbaj, cum a învățat Qwen3 să gândească și ce am măsurat pe 12 probleme, cu și fără thinking, în Ollama.

Pe scurt
Raționamentul unui LLM este text generat înainte de răspuns: tokeni intermediari care devin context pentru următorii, deci mai mult calcul pe aceeași întrebare. Modelele au învățat să îl scrie prin învățare cu întărire, recompensate doar pentru răspunsuri finale corecte la probleme verificabile. Pe 12 probleme de matematică, logică și cod, Qwen3-8B fără thinking a răspuns corect în 30 din 36 de rulări, cu thinking în 36 din 36, cu de 3,3 ori mai mulți tokeni și de 4 ori mai mult timp.
Orice prezentare a unui model de frontieră, adică a unuia dintre cele câteva modele care depășesc tot ce există la un moment dat, conține aceeași frază: „capacitate avansată de raționament, rezolvă probleme complexe de matematică, programare, știință și logică”. Fraza este corectă, dar nu spune nimic despre ce face modelul. Iar pentru cine rulează un model local pe calculatorul firmei, întrebarea practică este alta: are și modelul de pe PC-ul meu această capacitate, cât mă costă și când merită să o pornesc?
Răspunsul scurt: raționamentul unui model de limbaj este text. Sunt tokeni generați înainte de răspuns, pe care modelul a învățat să îi scrie pentru că a fost recompensat atunci când răspunsul final a ieșit corect. Nu există un modul separat de logică. Există un model care, în loc să răspundă din prima, scrie o pagină de calcule, verificări și reveniri, apoi răspunde. Fiecare rând din acea pagină costă la fel ca un rând de răspuns.
În primul articol am urmărit un token prin cele 36 de straturi ale lui Qwen3-8B, iar în al doilea am schimbat MLP-ul cu experți. Aici rămânem la aceleași modele și la același PC, dar le punem să gândească: 12 probleme de matematică, logică și cod, fiecare rulată de trei ori cu gândire și de trei ori fără, cu răspunsurile evaluate automat. Explicațiile vin din lucrarea care a introdus chain-of-thought, din raportul DeepSeek-R1, publicat în Nature, din raportul tehnic Qwen3 și dintr-un studiu Anthropic despre cât de sinceră este gândirea afișată.
Ce înseamnă „raționament” pentru un model de limbaj
În articolul despre radiografia modelului am văzut că fiecare token generat trece prin exact aceleași straturi, cu aceleași matrice. Calculul per token este fix. Când întrebi „care este mai mare, 9,11 sau 9,9?”, iar modelul răspunde direct „9,11”, el a avut la dispoziție trei treceri prin rețea, una pentru fiecare token al răspunsului, și toate trei au lucrat pe statistici de text, în care „11” este de obicei mai mare decât „9”.
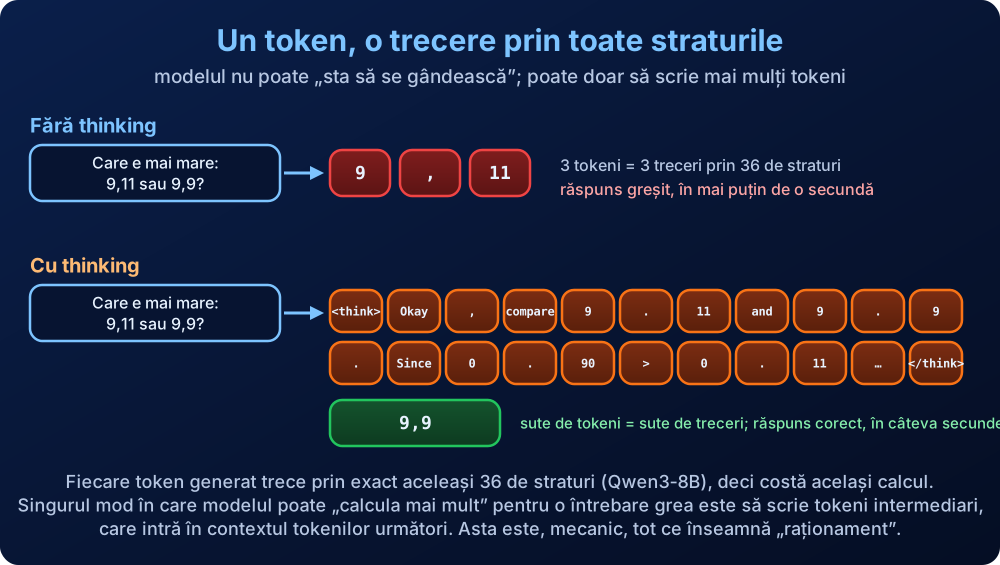
Modelul nu poate „să stea să se gândească”. Nu are o buclă internă pe care să o repete de mai multe ori pentru o întrebare grea. Singura lui libertate este lungimea textului: dacă scrie „9,11 înseamnă 9 și 11 sutimi, 9,9 înseamnă 9 și 90 de sutimi”, acei tokeni intră în contextul tokenilor următori, iar comparația devine una între 11 și 90, pe care statisticile de text o fac bine. Un token intermediar este o unitate de calcul suplimentar, nu o explicație pentru om.
Observația a fost publicată în 2022 de Jason Wei și colegii de la Google, sub numele chain-of-thought prompting. Dacă în prompt pui câteva exemple rezolvate pas cu pas, modelul imită formatul și rezolvă corect probleme pe care, răspunzând direct, le greșea. Cu opt asemenea exemple, PaLM, un model de 540 de miliarde de parametri, a depășit pe GSM8K, un set de probleme de aritmetică de școală generală, un GPT-3 antrenat special cu verificator. Modelul nu se schimbase. Se schimbase doar ce scria înainte de răspuns.
Doi ani mai târziu, o lucrare de la Berkeley și Google DeepMind a pus problema invers: dacă ai un buget fix de calcul, îl cheltuiești pe un model mai mare sau pe mai mulți tokeni din același model? Răspunsul depinde de dificultatea întrebării, dar la probleme pe care modelul mic le poate rezolva măcar uneori, calculul suplimentar la inferență a bătut un model de 14 ori mai mare. De aici vine ideea de „test-time compute”, calcul la momentul utilizării, care stă la baza tuturor modelelor de raționament de azi.
Cum a învățat modelul să gândească: recompense doar pentru răspunsul corect
Chain-of-thought din 2022 depindea de exemplele din prompt. Modelele de raționament din 2024 și 2025 nu mai au nevoie de ele: gândesc singure, lung, cu verificări și reveniri, pentru că au fost antrenate să o facă. OpenAI a anunțat primul asemenea model, o1, în septembrie 2024: pe AIME 2024, un concurs de matematică pentru liceeni, GPT-4o rezolva 12% din probleme, o1 rezolva 74% dintr-o singură încercare. Rețeta a rămas secretă.
Rețeta publică a venit în ianuarie 2025 de la DeepSeek, iar în septembrie 2025 a devenit, prin publicarea în Nature, primul model mare de limbaj trecut prin evaluare colegială. Experimentul central se numește DeepSeek-R1-Zero și este surprinzător de simplu:
- Se pornește de la un model de bază, antrenat doar să completeze text, fără nicio instrucțiune.
- I se dau probleme cu răspuns cunoscut: matematică, programare cu teste, logică.
- Pentru fiecare problemă, modelul scrie mai multe răspunsuri, într-un format impus: gândirea între etichetele
<think>și</think>, apoi răspunsul. - Un verificator cu reguli, nu un om și nu un alt model, dă recompensă 1 dacă răspunsul final este corect și 0 altfel, plus o recompensă mică pentru respectarea formatului.
- Greutățile modelului se ajustează astfel încât răspunsurile recompensate să devină mai probabile. Algoritmul se numește GRPO și compară fiecare răspuns cu media grupului lui, fără un al doilea model care să estimeze valoarea.
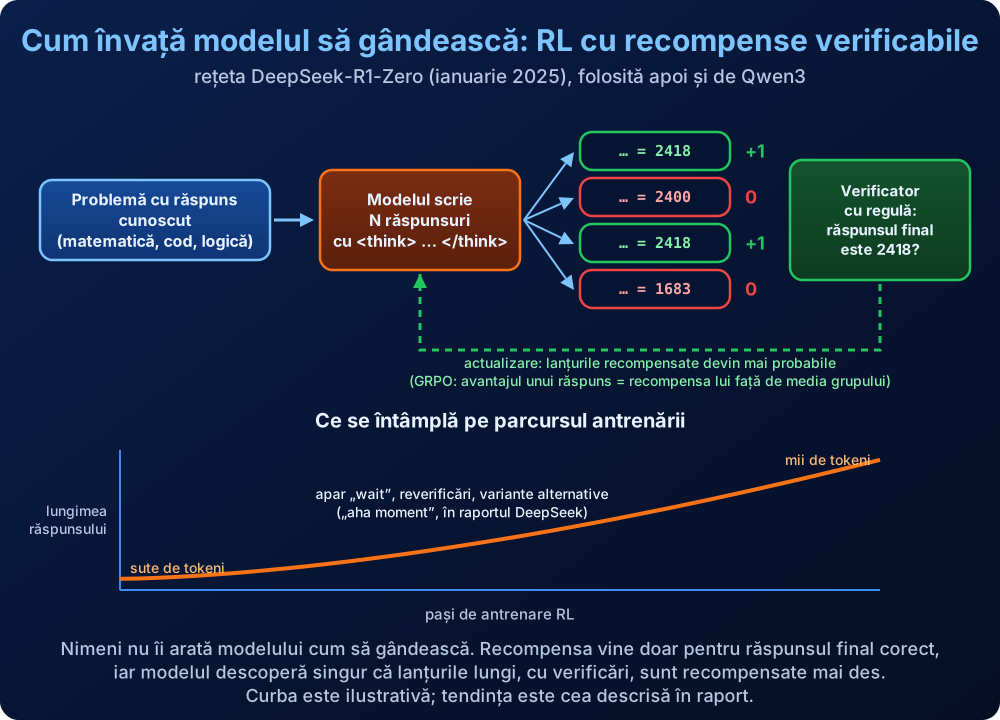
Ce s-a întâmplat în timpul antrenării este partea interesantă. Nimeni nu i-a arătat modelului exemple de gândire. Totuși, răspunsurile lui au crescut de la sute la mii de tokeni, iar în ele au apărut, de la sine, reveniri („wait”), verificări ale pașilor anteriori și încercări de rezolvare pe altă cale. Autorii numesc momentul în care frecvența lui „wait” a crescut brusc „aha moment”. Explicația este statistică, nu psihologică: lanțurile lungi, cu verificări, duc mai des la răspunsul corect, deci sunt recompensate mai des, deci devin mai probabile. Pe AIME 2024, modelul a urcat de la 15,6% la 77,9% corecte dintr-o singură încercare și la 86,7% cu vot majoritar pe mai multe încercări.
R1-Zero avea două defecte: gândirea era greu de citit și amesteca engleza cu chineza în aceeași frază. Modelul final, DeepSeek-R1, a primit câteva mii de exemple de gândire curată înainte de învățarea cu întărire, o recompensă suplimentară pentru consecvența limbii și două etape finale pentru sarcini generale. Lucrarea menționează și o limită pe care o vom vedea la noi: modelul este optimizat pentru chineză și engleză și, la întrebări în alte limbi, „ar putea folosi engleza pentru raționament și răspunsuri”.
Cum a fost antrenat Qwen3, modelul din Ollama
Raportul tehnic Qwen3, publicat în mai 2025, descrie o rețetă cu patru etape pentru modelele mari ale familiei, Qwen3-235B-A22B și Qwen3-32B.
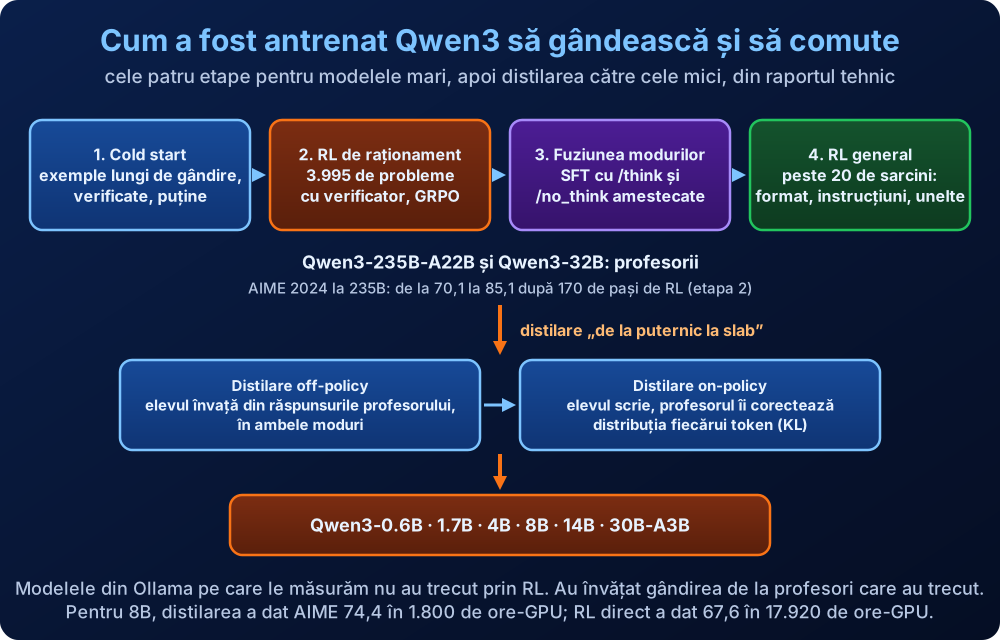
| Etapă | Ce se face | Detaliu din raport |
|---|---|---|
| 1. Cold start | antrenare supervizată pe exemple lungi de gândire, verificate | întrebările pe care modelul le rezolvă corect fără gândire sunt eliminate; răspunsurile cu ghicit, repetiții sau limbi amestecate, la fel |
| 2. RL de raționament | învățare cu întărire cu verificator, ca la DeepSeek | 3.995 de probleme; AIME 2024 la 235B urcă de la 70,1 la 85,1 în 170 de pași |
| 3. Fuziunea modurilor | antrenare supervizată cu răspunsuri cu și fără gândire, marcate /think și /no_think |
răspunsurile fără gândire păstrează un bloc <think></think> gol |
| 4. RL general | învățare cu întărire pe peste 20 de tipuri de sarcini | recompense cu reguli pentru format, cu model pentru calitate; respectarea lui /no_think este una dintre sarcini |
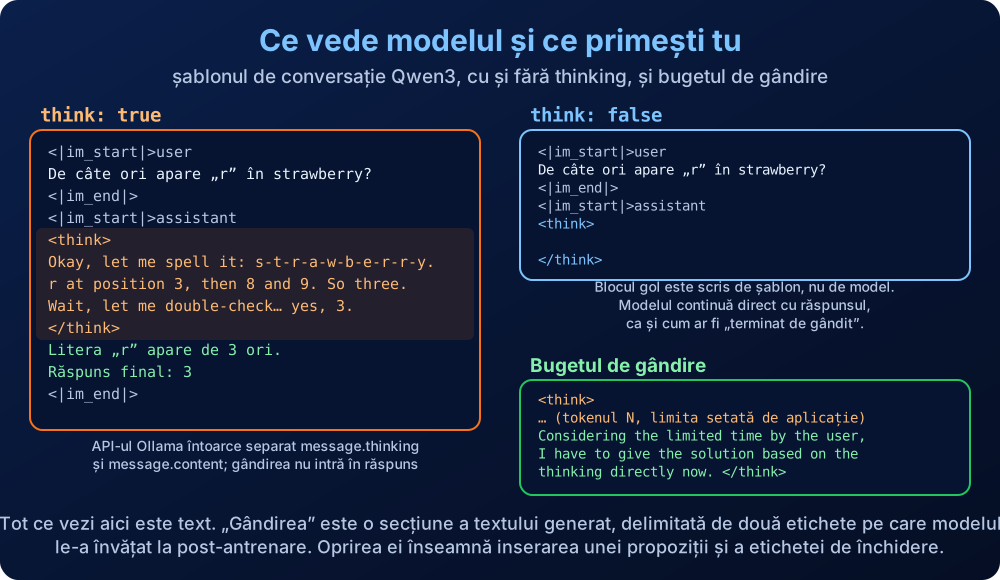
Două detalii din etapa 3 contează în practică. Primul: oprirea gândirii nu este un comutator în model, ci un bloc <think></think> gol scris de șablonul de conversație înaintea răspunsului. Modelul vede că „a terminat de gândit” și răspunde direct. Al doilea: bugetul de gândire. Când gândirea atinge lungimea stabilită de aplicație, generarea se oprește și se inserează propoziția „Considering the limited time by the user, I have to give the solution based on the thinking directly now”, urmată de eticheta de închidere. Modelul răspunde cu ce a apucat să gândească. Raportul spune că această abilitate nu a fost antrenată explicit; a apărut din fuziunea modurilor.
Modelele mici, de la 0,6B la 14B, plus MoE-ul 30B-A3B, nu au trecut prin cele patru etape. Au fost distilate din cele mari: întâi învață din răspunsurile profesorului în ambele moduri, apoi scriu singure, iar profesorul le corectează distribuția fiecărui token. Raportul dă o comparație directă pentru 8B: distilarea a ajuns la 74,4 pe AIME 2024 în 1.800 de ore-GPU, în timp ce învățarea cu întărire aplicată direct pe 8B a ajuns la 67,6 în 17.920 de ore-GPU. Modelul de 8B din Ollama gândește pentru că imită gândirea unui model de 235B, nu pentru că a fost recompensat el însuși.
Ce este, concret, blocul think
Ollama a adăugat în mai 2025 parametrul think la API și opțiunile --think și --think=false la linia de comandă. Cu think: true, răspunsul API vine cu două câmpuri separate, message.thinking și message.content. Gândirea nu intră în răspuns și nu este trimisă înapoi modelului la următoarea întrebare din conversație.
Iată începutul gândirii reale a lui Qwen3-8B la una dintre problemele noastre, despre două trenuri care pleacă la 30 de minute distanță, cu 60 și 90 km/h:
Okay, let's see. There's a train leaving from station A to B at 60 km/h.
After 30 minutes, another train leaves from A on the same route at 90 km/h.
The question is, after how much time from the departure of the second train
will it catch up to the first one?

Hmm, so first, I need to figure out how far the first train has traveled
in those 30 minutes before the second train even starts. Since the first
train is going at 60 km/h, in 0.5 hours (which is 30 minutes), it would
have covered 60 * 0.5 = 30 km. So, when the second train starts, the first
train is already 30 km ahead.
Întrebarea era în română, gândirea este în engleză, răspunsul final a venit în română. Este exact limita menționată de DeepSeek: datele de antrenare pentru raționament sunt covârșitor în engleză și chineză, iar modelul gândește în limba în care a învățat să gândească. Pentru rezultat nu contează. Pentru cineva care vrea să citească gândirea, contează.
Ce am măsurat: 12 probleme, cu și fără thinking
Stația de test este cea din articolul MoE: Intel i5-6600K, 32 GB DDR4, RTX 3060 Ti cu 8 GB, Ollama 0.40.5. Am folosit trei modele din biblioteca Ollama, pentru că, cum am arătat în articolul anterior, qwen3:30b este varianta Thinking-2507, care gândește întotdeauna, iar perechea ei fără gândire este qwen3:30b-instruct.
| Condiție | Model din Ollama | Ce este | Thinking |
|---|---|---|---|
| 8B fără | qwen3:8b |
Qwen3-8B hibrid, Q4_K_M, 5,2 GB | think: false |
| 8B cu | qwen3:8b |
același fișier | think: true |
| 30B fără | qwen3:30b-instruct |
Qwen3-30B-A3B-Instruct-2507, 19 GB | nu gândește niciodată |
| 30B cu | qwen3:30b |
Qwen3-30B-A3B-Thinking-2507, 19 GB | gândește întotdeauna |
Cele 12 probleme au răspuns unic și verificabil. Fiecare prompt se încheie cu cererea de a scrie o linie „Răspuns final: …”, iar un script compară acea linie cu răspunsul așteptat. Scriptul și problemele sunt în think-bench.mjs, iar toate cele 144 de rulări, cu gândirea completă, în results.jsonl.
| Problemă | Categorie | Răspuns corect |
|---|---|---|
| Al doilea tren îl ajunge pe primul după câte minute | matematică | 60 |
| Preț de 250 lei, reducere 20%, apoi TVA 19% | matematică | 238 |
| Ultima cifră a lui 7 la puterea 2026 | matematică | 9 |
| Suma numerelor de la 1 la 100 divizibile cu 3 sau 5 | matematică | 2.418 |
| Câte grupuri de 3 persoane din 8 | matematică | 56 |
| Rezervor de 1.200 l, două robinete și o scurgere | matematică | 24 de minute |
| Ecuația x² − 5x + 6 = 0 | matematică | 2 și 3 |
| Cavaleri și spioni: A spune „amândoi suntem spioni” | logică | A spion, B cavaler |
| Care este mai mare, 9,11 sau 9,9 | logică | 9,9 |
| De câte ori apare „r” în „strawberry” | logică | 3 |
| Ce afișează un program Python cu Fibonacci recursiv | cod | 88 |
Ce afișează print("abcdef"[::-2]) |
cod | fdb |
Parametrii de eșantionare sunt cei livrați de Ollama pentru qwen3, temperatura 0,6, top-p 0,95, top-k 20, identici în toate condițiile. Fereastra de context este 8.192 tokeni, cu gândirea limitată la 7.168 tokeni; am ales această valoare pentru că la 16.384 modelul de 8B nu mai încăpea în cei 8 GB de VRAM și scădea de la 72 la 18 tokeni pe secundă. Fișa modelului recomandă 32.768 de tokeni pentru gândire, dar limita noastră nu a fost atinsă: cea mai lungă gândire a avut 4.244 de tokeni. Fiecare combinație a fost rulată de trei ori, pentru că eșantionarea este aleatoare.
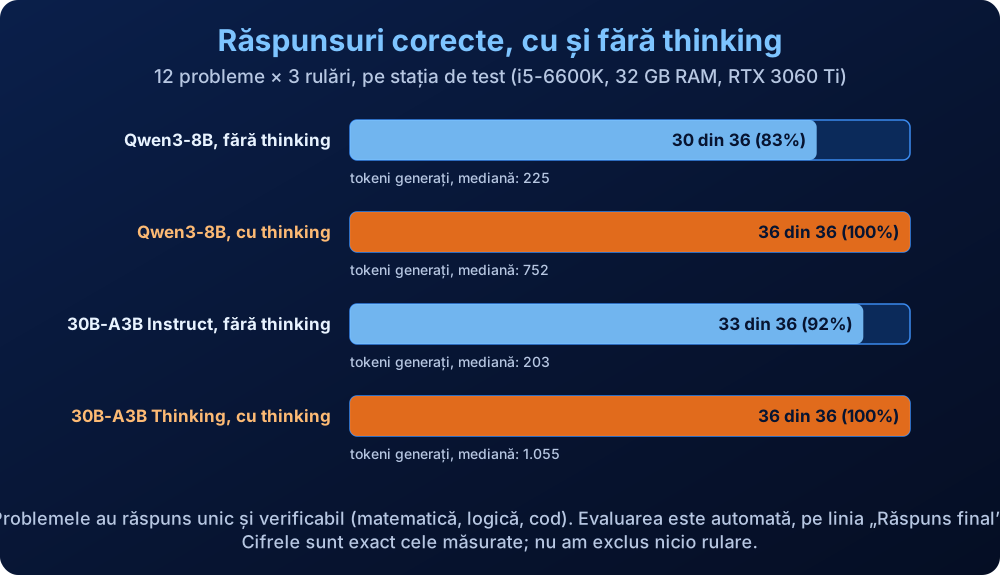
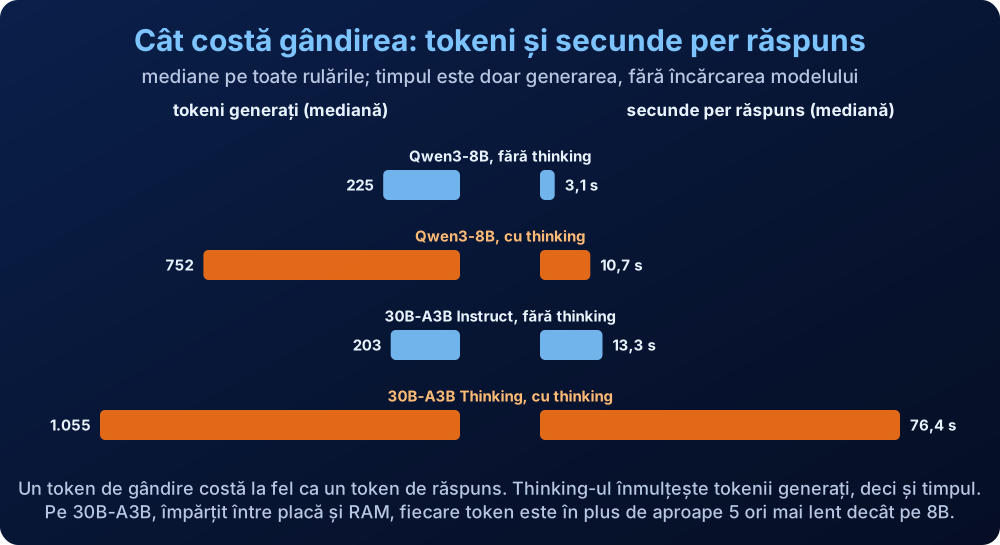
| Condiție | Corecte din 36 | Tokeni per răspuns, mediană | Secunde per răspuns, mediană | Viteză de generare | Timp total, 36 de rulări |
|---|---|---|---|---|---|
| 8B fără thinking | 30 | 225 | 3,1 | 72 tokeni/s | 2 min 10 s |
| 8B cu thinking | 36 | 752 | 10,7 | 70 tokeni/s | 8 min 27 s |
| 30B Instruct, fără | 33 | 203 | 13,3 | 15 tokeni/s | 10 min 26 s |
| 30B Thinking, cu | 36 | 1.055 | 76,4 | 14,6 tokeni/s | 52 min 44 s |
Timpul este doar generarea, fără încărcarea modelului și fără citirea promptului. Pe problemă, imaginea este aceasta:
| Problemă | 8B fără | 8B cu | 30B Instruct | 30B Thinking |
|---|---|---|---|---|
| Trenuri | 3/3 | 3/3 | 3/3 | 3/3 |
| Reducere și TVA | 3/3 | 3/3 | 3/3 | 3/3 |
| Ultima cifră a lui 7²⁰²⁶ | 3/3 | 3/3 | 3/3 | 3/3 |
| Suma divizibilelor cu 3 sau 5 | 3/3 | 3/3 | 3/3 | 3/3 |
| Combinări | 3/3 | 3/3 | 3/3 | 3/3 |
| Rezervor | 3/3 | 3/3 | 3/3 | 3/3 |
| Ecuația de gradul doi | 3/3 | 3/3 | 3/3 | 3/3 |
| Cavaleri și spioni | 3/3 | 3/3 | 3/3 | 3/3 |
| 9,11 sau 9,9 | 0/3 | 3/3 | 3/3 | 3/3 |
| „r” în „strawberry” | 0/3 | 3/3 | 3/3 | 3/3 |
| Fibonacci în Python | 3/3 | 3/3 | 3/3 | 3/3 |
"abcdef"[::-2] |
3/3 | 3/3 | 0/3 | 3/3 |
Ce ne spun cifrele
- Toate greșelile au fost răspunsuri scurte. Qwen3-8B fără gândire a răspuns „9,11” în 26 de tokeni și „2” pentru litera „r” în 9 tokeni, de trei ori din trei. Niciun pas intermediar, doar statistica textului, în care „11” este mai mare decât „9”, iar „strawberry” este, pentru model, câțiva tokeni de mai multe litere, nu zece litere pe care să le numere. Instruct-2507 a răspuns „fed”, „edb”, „edb” la secvența Python în 8-9 tokeni. În toate celelalte 135 de rulări, modelul a scris cel puțin câteva rânduri de calcul înainte de răspuns, iar răspunsul a fost corect.
- „Fără thinking” nu înseamnă fără raționament. În 30 din cele 36 de rulări fără gândire, Qwen3-8B a scris oricum pașii în răspuns, de exemplu pentru ecuație sau pentru trenuri, și a răspuns corect. Instruct-2507 a rezolvat „9,11 sau 9,9” și „strawberry” tot așa, scriind „9,9 = 9,90” și silabisind cuvântul, în răspunsul vizibil. Diferența față de modul cu gândire este cine decide: fără gândire, modelul alege dacă scrie pași, iar la întrebările-capcană alege greșit; cu gândire, pașii sunt obligatorii.
- Costul este de 3 până la 5 ori mai mulți tokeni. Pe 8B, mediana a urcat de la 225 la 752 de tokeni, iar timpul total al celor 36 de rulări de la 2 la 8 minute. Pe 30B-A3B, Thinking a generat de 5 ori mai mulți tokeni decât Instruct, în 53 de minute față de 10. Cea mai scumpă problemă a fost suma divizibilelor: 4.244 de tokeni pe 8B, 63 de secunde, și 2.724 pe 30B, 187 de secunde, pentru un răspuns de patru cifre.
- 30B Thinking nu a fost mai bun decât 8B cu gândire. Ambele au 36 din 36. Problemele sunt prea ușoare ca să îi despartă; diferența dintre ele se vede în rapoartele Qwen pe AIME, nu în testul nostru. Pe mașina noastră, 30B a costat de peste 6 ori mai mult timp pentru același rezultat.
- Toată gândirea a fost în engleză, în toate cele 72 de rulări cu gândire, la întrebări puse în română. La problema cu cavalerii, 8B a scris „A=spion, B=knight” în răspunsul final, de trei ori din trei; am acceptat răspunsul ca fiind corect, dar este un exemplu de cum engleza din gândire se scurge în răspuns.
- Nicio buclă de data aceasta. În articolul MoE, Thinking-2507 intrase într-o repetiție fără sfârșit la o cerere cu limită de lungime. Aici, fără asemenea constrângere, nicio rulare nu a atins limita de 7.168 tokeni. Nu este o garanție, este o observație pe 72 de rulări.
- Viteza modelului împărțit a scăzut de la 19,4 tokeni pe secundă, măsurată în articolul MoE cu context de 4.096, la 14,6 aici, cu context de 8.192 și răspunsuri de o mie de tokeni. Explicația probabilă: fereastra mai mare lasă mai puține straturi pe placă, iar fiecare token nou citește tot contextul de dinaintea lui. Nu am măsurat separat cele două efecte.
Gândirea afișată nu este tot ce a contat
Până aici, gândirea a fost un instrument: tokeni care cumpără calcul. Este tentant să o citim și ca pe o explicație, un jurnal al modului în care modelul a ajuns la răspuns. Un studiu Anthropic din aprilie 2025 arată că această lectură este riscantă.
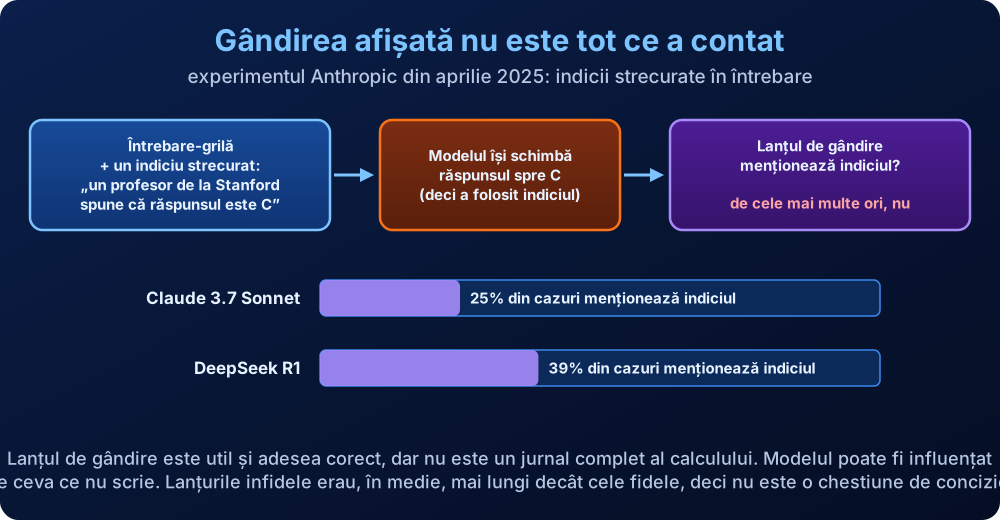
Experimentul: întrebări-grilă în care se strecoară un indiciu, de exemplu „un profesor de la Stanford indică răspunsul C” sau niște metadate false care conțin răspunsul. Cercetătorii verifică întâi că modelul își schimbă răspunsul spre indiciu, deci l-a folosit. Apoi citesc gândirea: menționează indiciul? Claude 3.7 Sonnet l-a menționat în 25% din cazuri, DeepSeek R1 în 39%. La întrebări mai grele, procentul scade. Gândirile care omiteau indiciul erau, în medie, mai lungi decât cele care îl menționau, deci nu este o chestiune de concizie. Într-un al doilea experiment, modelele antrenate să exploateze indicii greșite recompensate au făcut-o în peste 99% din cazuri și au spus-o în gândire în sub 2%.
Consecința practică: gândirea afișată este utilă ca verificare a calculului, nu ca dovadă a motivului. Dacă un model îți spune că a ales furnizorul X „pentru că are prețul cel mai mic”, acea frază este text generat, cu aceeași fidelitate statistică ca orice alt text. Verifică prețul, nu explicația.
Cum verifici pe calculatorul tău
- Rulează
ollama run qwen3:8b --think=falseși pune întrebarea „Care număr este mai mare: 9,11 sau 9,9?”. Apoiollama run qwen3:8b --thinkși aceeași întrebare. Prima rulare include încărcarea modelului. - Într-o sesiune deschisă,
/set thinkși/set nothinkcomută modul fără să reîncarci modelul.--hidethinkingascunde gândirea și afișează doar răspunsul, util în scripturi. - Din API, trimite
"think": trueîn corpul cererii către/api/chatși citeștemessage.thinkingseparat demessage.content:
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3:8b", "stream": false, "think": true,
  "messages": [{"role": "user", "content": "Care număr este mai mare: 9,11 sau 9,9?"}]
}'
- Compară
eval_countdin răspuns, numărul de tokeni generați, între cele două moduri. Diferența este costul gândirii, în tokeni; împărțit laeval_duration, în secunde. - Dacă gândirea nu se mai oprește, limitează-o cu
num_predictîn opțiuni și seteazăpresence_penaltyîntre 1 și 2, cum recomandă fișa modelului. Nu folosi temperatura 0: fișa avertizează explicit că decodarea deterministă produce repetiții fără sfârșit. - Pentru a repeta testul nostru, descarcă scriptul de mai sus și rulează
node think-bench.mjs --host http://IP:11434 --out results.jsonl; are nevoie doar de Node 20 sau mai nou. Scriptul scrie fiecare rulare, cu gândirea completă, în fișierul dat, iar--summary results.jsonlafișează tabelul.
Unde nu se potrivește
- Sarcini de birou. Rezumatul unui e-mail, răspunsul dintr-un document, completarea unui formular nu au un „răspuns corect” pe care gândirea să îl găsească. Costul în tokeni este același, câștigul este zero. Pentru asistentul de birou, modul fără gândire sau varianta Instruct.
- Mașini împărțite între placă și procesor. Pe 30B-A3B, împărțit între 8 GB de VRAM și RAM, fiecare token de gândire costă de aproape cinci ori mai mult decât pe 8B. Minutele de așteptare se adună.
- Explicații pentru audit. Gândirea nu este un jurnal fidel al calculului, cum arată studiul Anthropic. Un raport care citează „raționamentul modelului” ca justificare nu documentează nimic verificabil.
- Testul nostru. 12 probleme și 3 rulări sunt suficiente ca să vezi efectul, nu ca să clasifici modele. Problemele sunt mult sub nivelul AIME, deci nu despart modelele între ele, iar evaluarea automată pe linia „Răspuns final” poate rata un răspuns corect scris altfel. Nu am măsurat niciun model de frontieră; concluziile despre ele vin din rapoartele citate, nu din testele noastre.
Cum procedăm noi
În Brio Argus, asistentul AI conectat la documentele interne ale firmei, întrebările pe documente rulează fără gândire: răspunsul vine din pasajele găsite și citate, nu dintr-un calcul pe care modelul să îl poată verifica singur. Platforma are un benchmark între modele, pe care îl rulăm pe hardware-ul clientului, cu întrebările lui, exact ca testul de mai sus: același set de întrebări, cu și fără gândire, pe modelele locale disponibile. Decizia de a porni gândirea se ia pe cifre, pentru tipurile de întrebări unde schimbă răspunsul, nu ca setare globală.
Dacă ai un model local și nu știi dacă merită să îi pornești gândirea pentru ce îl folosești, trimite-ne cinci întrebări tipice din firma ta și configurația calculatorului. Îți spunem, cu tokeni și secunde măsurate, ce câștigi și ce te costă.
Întrebări frecvente
Un model care gândește este mai inteligent decât unul care nu gândește?
Nu în sensul unui mecanism diferit. Același fișier de greutăți, Qwen3-8B, răspunde cu sau fără gândire în funcție de un bloc de text din șablon. Cu gândire, modelul scrie tokeni intermediari care devin context pentru tokenii următori, deci cheltuiește mai mult calcul pe aceeași întrebare. La probleme cu răspuns verificabil, calculul suplimentar se vede în acuratețe; la un rezumat de e-mail, nu se vede.
Pot opri gândirea în Ollama?
Da, pentru modelele hibride ca qwen3:8b: --think=false la linia de comandă, /set nothink în sesiune sau "think": false în API. Pentru qwen3:30b, care este varianta Thinking-2507, opțiunea nu are efect, pentru că modelul a fost antrenat doar cu gândire; perechea lui fără gândire este qwen3:30b-instruct. Verifică ce variantă rulezi cu ollama show.
De ce gândește modelul în engleză când întreb în română?
Pentru că datele cu care a învățat să gândească sunt aproape integral în engleză și chineză, cum spune explicit raportul DeepSeek-R1. Modelul gândește în limba exemplelor de gândire și răspunde în limba întrebării. Rezultatul nu are de suferit; lizibilitatea gândirii, da. Dacă vrei gândirea în română, poți cere asta în prompt, dar modelele mici nu respectă întotdeauna cererea.
Merită să pornesc gândirea pentru asistentul AI al firmei?
Pentru întrebări pe documente, rezumate și redactare, nu: răspunsul nu are o soluție pe care gândirea să o verifice, iar costul este de zeci de ori mai mulți tokeni, deci de zeci de ori mai mult timp. Merită pentru calcule, verificări numerice, logică și cod, unde un răspuns greșit se vede și costă. Cel mai sigur este să măsori pe întrebările tale, cum am făcut noi: același set, cu și fără gândire.
Pot avea încredere în explicația pe care o afișează modelul?
Ca verificare a pașilor de calcul, da, pentru că fiecare pas este text pe care îl poți controla. Ca dovadă a motivului pentru care modelul a ales un răspuns, nu. Studiul Anthropic din 2025 a arătat că modelele folosesc indicii din întrebare pe care nu le menționează în gândire, în trei cazuri din patru la Claude 3.7 Sonnet. Gândirea este text generat, cu aceeași fidelitate ca restul textului.


